Für Unternehmen
Schatten-KI im Unternehmen: So führen Sie sichere Regeln für ChatGPT und Copilot ein
Schatten-KI im Unternehmen sicher steuern: Mit klaren Regeln für ChatGPT und Copilot schützt du vertrauliche Daten und stärkst Kompetenzen.
 KI-generiert
Montagmorgen, kurz vor einem Kundentermin: Eine Mitarbeiterin lässt eine lange E-Mail von ChatGPT zusammenfassen, ein Kollege formuliert mit Copilot einen Projektstatus, ein dritter kopiert Fehlermeldungen aus einem Kundensystem in einen KI-Chat. Keiner will Regeln umgehen. Alle wollen schneller arbeiten. Genau so entsteht Schatten-KI: die Nutzung generativer KI außerhalb klarer technischer, rechtlicher und organisatorischer Leitplanken.
Für Unternehmen ist das kein Randthema. Generative KI ist längst im Büroalltag angekommen, auch dort, wo es keine offiziell eingeführte KI-Plattform gibt. Ein pauschales Verbot löst das Problem selten. Es führt eher dazu, dass Mitarbeitende nützliche Tools weiterhin einsetzen, nur ohne Rückfrage und ohne sichere Prozesse. Besser ist ein realistischer Rahmen: Was ist erlaubt, welche Daten dürfen verarbeitet werden, welche Werkzeuge sind freigegeben und wann braucht es eine Prüfung?
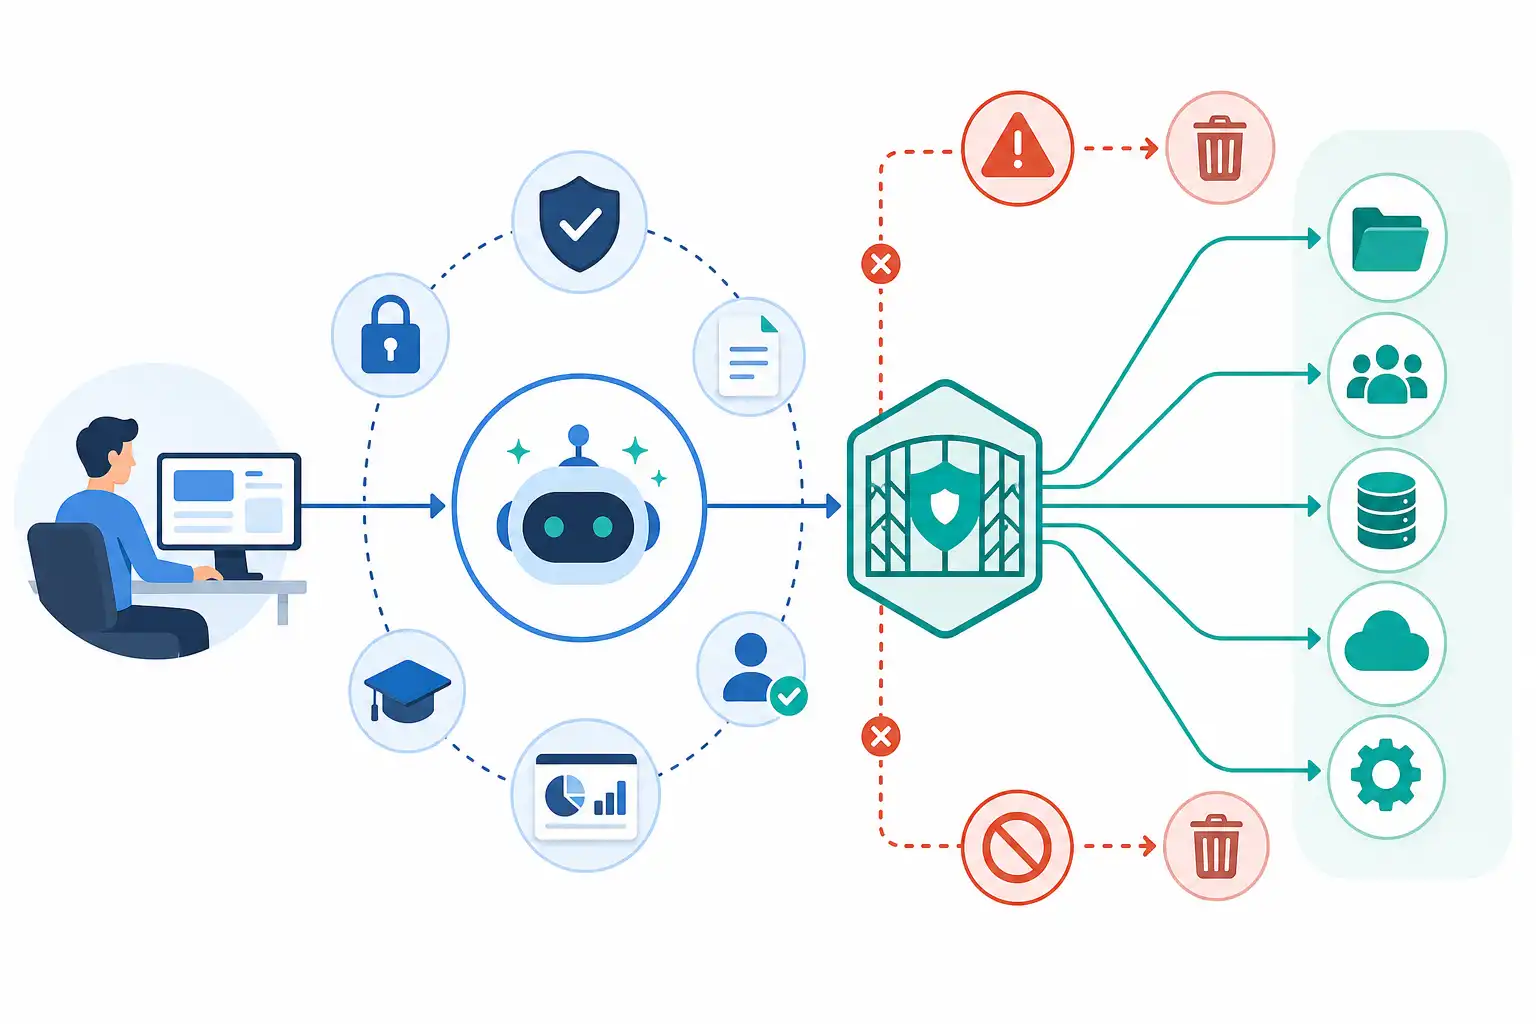
Infografik zu Schatten-KI im Unternehmen: So führen Sie sichere Regeln für ChatGPT und Copilot ein (KI-generiert).
Was Schatten-KI konkret bedeutet
Von Schatten-KI sprechen wir, wenn Mitarbeitende KI-Tools für Arbeitsaufgaben nutzen, ohne dass diese Nutzung im Unternehmen geregelt, geprüft oder freigegeben ist. Dabei geht es nicht nur um öffentliche Chatbots. Auch Browser-Erweiterungen, KI-Funktionen in Standardsoftware, Transkriptionsdienste, Bildgeneratoren oder Coding-Assistenten können dazugehören.
Schatten-KI entsteht häufig aus nachvollziehbaren Gründen:
- Mitarbeitende sparen Zeit bei Routineaufgaben.
- Teams möchten Texte, Präsentationen oder Analysen schneller vorbereiten.
- Entwicklerinnen und Entwickler nutzen KI für Erklärungen, Tests oder Code-Vorschläge.
- Es gibt keine klare Anlaufstelle für Fragen zur KI-Nutzung.
- Offiziell bereitgestellte Werkzeuge fehlen oder sind für reale Arbeitsabläufe zu umständlich.
Die zentrale Frage lautet deshalb nicht: „Wie verhindern wir jede KI-Nutzung?“ Sie lautet: „Wie schaffen wir sichere und praktikable Wege für sinnvolle KI-Nutzung?“
Die Risiken liegen meist in den Eingaben
Generative KI kann Texte entwerfen, Inhalte strukturieren, Code erklären oder Ideen liefern. Das Risiko beginnt oft schon vor der Antwort des Systems, nämlich bei den Informationen, die Mitarbeitende eingeben.
Besonders kritisch sind:
- personenbezogene Daten von Kundinnen, Kunden oder Beschäftigten
- Vertragsinhalte, Angebote und Kalkulationen
- interne Strategiepapiere und noch nicht veröffentlichte Geschäftszahlen
- Zugangsdaten, Schlüssel, Tokens und Konfigurationsdateien
- Quellcode, Architekturinformationen und Sicherheitslücken
- Gesundheitsdaten, Bewerbungsunterlagen oder arbeitsrechtliche Inhalte
- Daten aus Supportfällen, Tickets und CRM-Systemen
Auch scheinbar harmlose Angaben können in Kombination sensibel sein. Ein Firmenname, eine besondere technische Störung und ein Kundenzitat reichen manchmal aus, um einen Vorgang zuzuordnen. Deshalb brauchen Mitarbeitende keine abstrakten Datenschutzvorträge, sondern verständliche Regeln für ihren konkreten Arbeitsalltag.
Eine gute Grundregel lautet: Was du nicht in einer öffentlichen Präsentation zeigen würdest, gehört nicht unbesehen in ein nicht freigegebenes KI-Tool.
Erst Transparenz schaffen, dann Regeln einführen
Bevor du eine KI-Richtlinie schreibst, solltest du verstehen, was im Unternehmen tatsächlich passiert. Das ist keine Kontrolle einzelner Personen, sondern eine Bestandsaufnahme von Arbeitsabläufen und Risiken.
Sprich mit Teams aus Vertrieb, Personal, Entwicklung, Marketing, Kundenservice, Recht, IT und Informationssicherheit. Frage konkret:
- Welche KI-Tools werden bereits genutzt?
- Für welche Aufgaben werden sie eingesetzt?
- Welche Daten werden typischerweise eingegeben?
- Welche Funktionen fehlen in bestehenden Werkzeugen?
- Wo entstehen Unsicherheiten?
- Welche Aufgaben wären besonders geeignet, wenn sichere Tools verfügbar wären?
Oft zeigt sich: Die Mehrheit der Anwendungsfälle ist grundsätzlich sinnvoll. Texte zusammenfassen, Gliederungen erstellen, Formulierungen überarbeiten, öffentlich verfügbare Informationen strukturieren oder Testfälle entwerfen kann Arbeit erleichtern. Problematisch werden solche Fälle erst, wenn vertrauliche Inhalte ohne Schutzmechanismen verarbeitet werden oder Ergebnisse ungeprüft in Entscheidungen einfließen.
Eine KI-Richtlinie muss im Alltag funktionieren
Eine gute Richtlinie ist kurz genug, dass sie gelesen wird, und konkret genug, dass Mitarbeitende danach handeln können. Ein mehrseitiges Dokument voller juristischer Formulierungen hilft im hektischen Arbeitsalltag selten weiter.
Bewährt hat sich eine Einteilung in drei Kategorien:
| Kategorie | Umgang mit Daten | Typische Beispiele |
|---|---|---|
| Grün | Nutzung in freigegebenen Tools erlaubt | Allgemeine Textideen, öffentlich verfügbare Inhalte, neutrale Übersetzungen |
| Gelb | Nur nach Anonymisierung oder mit festgelegtem Prozess | Supporttexte ohne Personenbezug, technische Fehlerbeschreibungen ohne Zugangsdaten |
| Rot | Keine Eingabe in generative KI ohne ausdrückliche Freigabe | Personenbezogene Daten, Verträge, Geschäftsgeheimnisse, Zugangsdaten, vertraulicher Quellcode |
Wichtig ist, diese Kategorien mit Beispielen aus dem eigenen Unternehmen zu füllen. „Vertrauliche Daten“ ist zu ungenau. Ein Team im Kundenservice braucht andere Beispiele als die Softwareentwicklung oder die Personalabteilung.
Zur Richtlinie gehören außerdem klare Aussagen zu folgenden Punkten:
- Welche KI-Tools sind freigegeben?
- Welche Konten dürfen genutzt werden?
- Darf ein privates Konto für berufliche Zwecke verwendet werden?
- Welche Daten sind grundsätzlich ausgeschlossen?
- Wann müssen Ergebnisse fachlich geprüft werden?
- Wer entscheidet über neue Tools oder neue Einsatzszenarien?
- Wo können Mitarbeitende Fragen stellen oder Vorfälle melden?
Freigaben brauchen einen einfachen Prozess
Wenn jede Idee erst durch mehrere Gremien muss, wird die Richtlinie umgangen. Wenn jede Person Tools eigenständig auswählt, entstehen Sicherheitslücken und schwer kontrollierbare Kosten. Der richtige Weg liegt dazwischen: ein schneller, nachvollziehbarer Freigabeprozess.
Für neue KI-Anwendungsfälle reicht oft ein kompaktes Formular mit diesen Fragen:
- Welches Problem soll gelöst werden?
- Welches Tool ist vorgesehen?
- Welche Datenarten werden verarbeitet?
- Gibt es personenbezogene oder vertrauliche Inhalte?
- Wer nutzt das Tool und in welchem Umfang?
- Wie werden Ergebnisse geprüft?
- Welche Risiken bestehen bei falschen oder erfundenen Antworten?
- Welche Alternative ohne externe Datenverarbeitung gibt es?
Je nach Risiko sollten Fachbereich, IT, Datenschutz, Informationssicherheit und gegebenenfalls Rechtsabteilung eingebunden werden. Nicht jeder Fall benötigt dieselbe Prüfungstiefe. Eine Ideensammlung für öffentliches Marketingmaterial ist anders zu bewerten als ein KI-System, das Bewerbungen vorsortiert oder Kundenkommunikation automatisiert.
ChatGPT und Copilot nicht einfach gleich behandeln
ChatGPT und Copilot sind bekannte Namen, aber keine einheitlichen Produkte mit identischen Einstellungen, Datenflüssen oder Unternehmensfunktionen. Entscheidend ist immer, welche konkrete Variante eingesetzt wird, über welches Konto sie genutzt wird und welche Einstellungen vereinbart oder administriert wurden.
Deshalb sollte deine Richtlinie nicht nur Produktnamen nennen. Sie sollte festlegen, welche unternehmensseitig eingerichteten Zugänge erlaubt sind und welche Funktionen darin genutzt werden dürfen. Private Zugänge und nicht geprüfte Browser-Erweiterungen sollten für Arbeitsdaten klar ausgeschlossen sein.
Auch bei freigegebenen Tools bleibt die Prüfung durch Menschen unverzichtbar. Generative KI kann überzeugend formulierte, aber falsche Aussagen liefern. Sie kann Quellen erfinden, Begriffe verwechseln oder wichtige Einschränkungen auslassen. Mitarbeitende müssen wissen: KI-Ergebnisse sind Entwürfe, keine verlässlichen Fakten.
Das gilt besonders für technische Teams. Wer mit KI Code erstellt oder verändert, muss Abhängigkeiten, Sicherheitsfolgen, Lizenzfragen und Tests berücksichtigen. Unser Beitrag Programmieren lernen mit KI-Coding-Assistenten: So übst du richtig statt nur Code zu kopieren zeigt, warum KI beim Lernen und Entwickeln Unterstützung bieten kann, aber keine eigene fachliche Prüfung ersetzt.
Kompetenzaufbau ist die wirksamste Schutzmaßnahme
Eine Richtlinie allein verändert keine Gewohnheiten. Mitarbeitende brauchen Sicherheit im Umgang mit generativer KI, damit sie Risiken erkennen und gute Einsatzmöglichkeiten nutzen können.
Eine praxisnahe Schulung sollte unter anderem vermitteln:
- Was generative KI leisten kann und was nicht
- Welche Daten niemals eingegeben werden dürfen
- Wie Anonymisierung und Datenminimierung praktisch funktionieren
- Warum Ergebnisse geprüft werden müssen
- Wie gute Prompts für erlaubte Anwendungsfälle aussehen
- Wie mit fehlerhaften, diskriminierenden oder unsicheren Ergebnissen umzugehen ist
- Welche internen Ansprechpartner zuständig sind
Am wirksamsten sind Übungen mit echten, aber bereinigten Arbeitssituationen. Lass Teams beispielsweise eine neutrale E-Mail verbessern, ein Meetingprotokoll strukturieren oder Testfälle aus einer anonymisierten Anforderung ableiten. So wird aus einer abstrakten Vorgabe konkrete Handlungssicherheit.
Für einen umfassenderen Blick auf betriebliche Anforderungen empfehlen wir auch unseren Ratgeber EU AI Act: Welche KI-Schulung brauchen Mitarbeitende jetzt?. Gerade bei KI-Systemen mit höherem Risiko müssen Rollen, Kompetenzen und Verantwortlichkeiten sauber zusammenpassen.
Technische Maßnahmen ergänzen die Regeln
Organisatorische Regeln und Schulungen sind unverzichtbar, aber sie sollten durch technische Maßnahmen ergänzt werden. Welche Maßnahmen sinnvoll sind, hängt von der vorhandenen IT-Landschaft und dem jeweiligen Tool ab.
Typische Ansatzpunkte sind:
- zentrale Benutzerkonten statt privater Anmeldungen
- rollenbasierte Berechtigungen
- Mehrfaktor-Authentifizierung
- geprüfte Integrationen mit Unternehmensdaten
- Protokollierung und regelmäßige Überprüfung der Nutzung
- klare Vorgaben für Dateiuploads und externe Verbindungen
- Sicherheitsprüfungen vor der Anbindung von KI an interne Systeme
Besonders wichtig wird das, wenn KI auf Wissensdatenbanken, Ticketsysteme oder Unternehmensdokumente zugreifen soll. Dann geht es nicht mehr nur um einzelne Prompts, sondern um Berechtigungen, Datenzugriffe und mögliche Fehlkonfigurationen. Grundlagen dazu findest du in unserem Beitrag IAM lernen für den Quereinstieg: Berechtigungen, SSO und Zero Trust verstehen.
So startest du in den nächsten 30 Tagen
Du musst nicht auf die perfekte KI-Governance warten. Starte mit einem klaren Mindeststandard und verbessere ihn Schritt für Schritt.
- Benenne eine verantwortliche Stelle für KI-Fragen.
- Erfasse die wichtigsten bereits genutzten Tools und Anwendungsfälle.
- Veröffentliche eine kurze Übergangsregel mit erlaubten, eingeschränkten und verbotenen Daten.
- Stelle mindestens einen sicheren, nachvollziehbaren Nutzungsweg bereit.
- Führe kurze Schulungen mit realistischen Beispielen durch.
- Richte einen einfachen Prozess für neue Anwendungsfälle ein.
- Überprüfe Richtlinie und Freigaben regelmäßig anhand neuer Anforderungen.
Wenn du Kompetenzen nicht nur bei einzelnen KI-Verantwortlichen, sondern in Teams aufbauen willst, ist ein strukturierter Lernpfad sinnvoll. Passende Seminare und Termine findest du bei uns auf cmt.de.
Schatten-KI verschwindet nicht, indem Unternehmen wegschauen oder nur Verbote aussprechen. Sie wird beherrschbar, wenn Mitarbeitende sichere Alternativen kennen, Risiken einordnen können und bei Unsicherheiten schnell Unterstützung bekommen. So wird aus unkontrollierter Tool-Nutzung eine verantwortungsvolle KI-Praxis, die Produktivität und Schutz vertraulicher Informationen zusammenbringt.
Nächster Schritt
Passenden Kurs zu Für Unternehmen finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen