Tech-Felder
OpenTelemetry lernen für den Quereinstieg: So verstehst du Logs, Metriken und Traces
OpenTelemetry lernen für den Quereinstieg: Verstehe Logs, Metriken und Traces und finde Fehler in Cloud-Anwendungen systematisch.
 KI-generiert
Ein Shop ist plötzlich langsam, aber die Startseite lädt noch. Im Monitoring steigt die Fehlerrate nur leicht, die Datenbank wirkt unauffällig und im Log steht dieselbe kryptische Fehlermeldung hundertfach. Genau in solchen Situationen zeigt sich, warum Observability mehr ist als ein Dashboard mit grünen und roten Kurven. Du musst nachvollziehen können, welcher Service eine Anfrage verarbeitet hat, wo Zeit verloren ging und welche Änderung den Fehler ausgelöst haben könnte. OpenTelemetry gibt dir dafür eine gemeinsame technische Grundlage.
Für den Quereinstieg in DevOps, Platform Engineering oder Cloud Security wird diese Kompetenz immer relevanter. Anwendungen bestehen heute oft aus mehreren APIs, Containern, Datenbanken, Warteschlangen und externen Diensten. Produktive KI-Anwendungen bringen zusätzlich Modellaufrufe, Retrieval-Systeme, Tools und Hintergrundjobs mit. Ein einzelnes Serverlog reicht nicht mehr aus, um Probleme zuverlässig einzugrenzen.
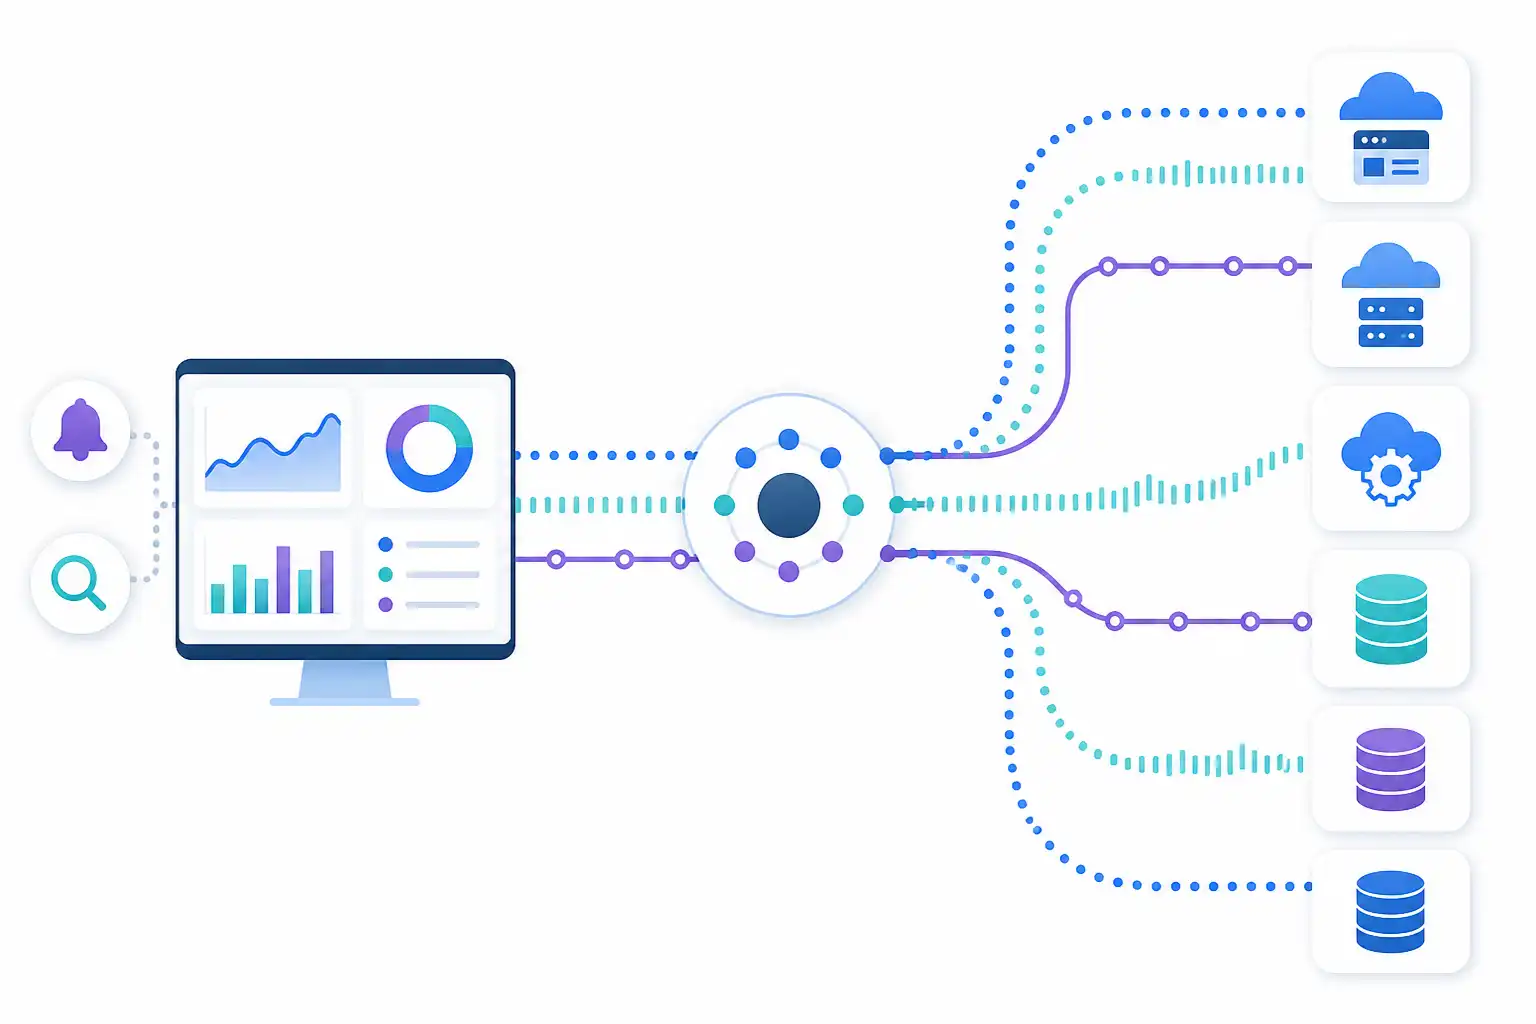
Infografik zu OpenTelemetry lernen für den Quereinstieg: So verstehst du Logs, Metriken und Traces (KI-generiert).
Was OpenTelemetry eigentlich ist
OpenTelemetry, oft mit OTel abgekürzt, ist ein herstellerneutraler Standard für Telemetriedaten. Gemeint sind technische Signale, die eine Anwendung im Betrieb erzeugt und die Teams für Analyse, Fehlerbehebung und Optimierung nutzen.
OpenTelemetry liefert nicht automatisch eine fertige Monitoring-Oberfläche. Es beschreibt vielmehr, wie Anwendungen Daten erfassen, mit Kontext anreichern und an ein Zielsystem weitergeben. Dieses Zielsystem kann eine Cloud-Plattform, ein spezialisiertes Observability-Produkt oder eine selbst betriebene Lösung sein.
Für deinen Einstieg ist diese Trennung wichtig:
| Baustein | Aufgabe |
|---|---|
| Instrumentierung | Erzeugt Telemetriedaten im Code oder durch automatische Bibliotheken |
| OpenTelemetry SDK | Steuert, welche Daten erfasst und verarbeitet werden |
| OpenTelemetry Collector | Nimmt Daten entgegen, verarbeitet und verteilt sie weiter |
| Backend | Speichert, durchsucht und visualisiert Telemetriedaten |
In der Praxis instrumentiert ein Entwicklungsteam etwa einen Webservice. Dieser erzeugt Traces und Metriken, schreibt strukturierte Logs und exportiert die Daten an einen Collector. Der Collector kann sensible Felder entfernen, Daten bündeln oder an mehrere Ziele weiterleiten. Im Backend untersucht ein Team dann beispielsweise eine langsame Anfrage.
Das klingt zunächst nach Infrastrukturthema. Tatsächlich verbindet OpenTelemetry mehrere Rollen: Softwareentwicklung muss sinnvolle Signale erzeugen, Cloud- und Platform-Teams stellen Erfassung und Speicherung bereit, DevOps-Teams definieren Alarmierungen und Security-Teams achten auf Datenzugriffe sowie vertrauliche Inhalte.
Die drei Signale: Logs, Metriken und Traces
Wer OpenTelemetry lernen möchte, sollte nicht mit Konfigurationsdateien beginnen, sondern mit der Funktion der drei wichtigsten Signalarten. Sie beantworten unterschiedliche Fragen.
Logs: Was ist konkret passiert?
Logs sind einzelne Ereignisse mit Zeitstempel. Ein Logeintrag kann festhalten, dass ein Nutzer sich angemeldet hat, eine Datei nicht verarbeitet werden konnte oder ein externer Dienst einen Fehler zurückgab.
Gute Logs sind strukturiert. Statt einen langen Freitext zu schreiben, hinterlegst du Felder wie Service-Name, Umgebung, Fehlerklasse, Nutzerrolle oder Auftrags-ID. So lassen sich Logs gezielt filtern und aggregieren.
Ein hilfreiches Log beantwortet oft diese Fragen:
- Welcher Service hat das Ereignis ausgelöst?
- Wann ist es passiert?
- Welche Anfrage oder welcher Auftrag war betroffen?
- Welche Fehlerklasse und welche technische Ursache liegen vor?
- Lassen sich ähnliche Ereignisse häufen?
Wichtig: Logs dürfen keine Zugangsdaten, vollständigen Zahlungsdaten, privaten Schlüssel oder unnötigen personenbezogenen Inhalte enthalten. Observability ist kein Freibrief, jede Nutzereingabe zentral zu speichern. Gerade bei KI-Anwendungen musst du Prompts, Dokumentinhalte und Modellantworten bewusst behandeln.
Metriken: Wie entwickelt sich das System?
Metriken sind messbare Werte über einen Zeitraum. Typische Beispiele sind die Anzahl eingehender Anfragen, Antwortzeiten, Fehlerraten, CPU-Auslastung oder die Länge einer Warteschlange.
Metriken helfen dir vor allem, Muster zu erkennen. Wenn die Antwortzeit seit dem letzten Deployment steigt, ist das ein Signal zur Untersuchung. Wenn ein Service regelmäßig an seine Speichergrenze kommt, kannst du Kapazitäten planen oder eine Skalierungsregel prüfen.
Für Einsteiger sind vier Metrikgruppen besonders nützlich:
- Zähler: Wie viele Ereignisse gab es insgesamt, etwa erfolgreiche Bestellungen oder fehlgeschlagene Anmeldungen?
- Histogramme: Wie verteilen sich Werte, etwa Latenzen von API-Anfragen?
- Messwerte: Welchen aktuellen Stand hat eine Größe, etwa Speichernutzung?
- Zusammenfassungen: Wie sehen zusammengefasste Verteilungen über ein Zeitfenster aus?
Entscheidend ist nicht, möglichst viele Kennzahlen zu sammeln. Eine Kennzahl muss eine Frage beantworten. „Wie schnell reagiert unsere Checkout-API für Nutzer?“ ist eine sinnvolle Frage. „Wir erfassen alles, was technisch möglich ist“ führt dagegen schnell zu unnötigen Kosten und unübersichtlichen Dashboards.
Traces: Welchen Weg nahm eine Anfrage?
Traces sind der Kern von Observability in verteilten Systemen. Ein Trace verfolgt den Weg einer einzelnen Anfrage über mehrere Komponenten hinweg. Er besteht aus Spans. Ein Span repräsentiert einen abgegrenzten Arbeitsschritt, zum Beispiel einen HTTP-Aufruf, eine Datenbankabfrage oder das Senden einer Nachricht an eine Warteschlange.
Stell dir vor, ein Nutzer lädt in einer Anwendung einen Bericht herunter. Der erste Service prüft Berechtigungen, ruft einen weiteren Dienst auf, dieser fragt Daten ab und erzeugt eine Datei im Objektspeicher. Wenn der Download langsam ist, zeigt ein Trace, ob die Berechtigungsprüfung, die Datenbank oder die Dateierzeugung Zeit kostet.
Jeder Trace braucht eine eindeutige Trace-ID. Wird diese ID in Logs übernommen, kannst du vom auffälligen Trace direkt zu den passenden Logeinträgen springen. Diese Korrelation macht aus getrennten Datenquellen ein nutzbares Bild.
So lernst du OpenTelemetry praktisch
Für den Quereinstieg musst du nicht sofort eine komplexe Produktionslandschaft aufbauen. Sinnvoller ist ein kleines System, das du selbst verstehst und schrittweise instrumentierst.
Starte mit einer einfachen Anwendung, etwa einer kleinen API mit zwei Endpunkten und einer Datenbank. Programmiersprachen mit gut verfügbaren OpenTelemetry-Bibliotheken sind Python, Java, JavaScript oder Go. Wenn du noch Grundlagen aufbaust, hilft dir unser Beitrag Programmieren lernen mit KI-Coding-Assistenten: So übst du richtig statt nur Code zu kopieren, damit du die Instrumentierung nachvollziehst statt Konfigurationen ungeprüft zu übernehmen.
Arbeite anschließend in dieser Reihenfolge:
- Starte die Anwendung lokal und rufe einen Endpunkt mehrfach auf.
- Aktiviere automatische Instrumentierung für HTTP-Anfragen und Datenbankzugriffe.
- Vergib für den Service einen klaren Namen und unterscheide lokale Umgebung, Test und Produktion.
- Ergänze einen eigenen Span für einen wichtigen Fachschritt, etwa „Bericht erzeugen“.
- Schreibe strukturierte Logs und füge die Trace-ID hinzu.
- Erzeuge absichtlich einen Fehler, beispielsweise durch eine ungültige Datenbankverbindung.
- Suche den Trace, prüfe die zugehörigen Spans und vergleiche sie mit den Logs.
- Miss eine Antwortzeit als Metrik und überprüfe, wie sie sich bei mehreren Anfragen verändert.
Dabei lernst du nicht nur Werkzeuge, sondern eine Denkweise: Du formulierst erst eine Hypothese und suchst dann passende Signale. „Die Datenbank ist langsam“ ist eine Hypothese. Ein Trace mit langer Datenbankspan und eine erhöhte Latenzmetrik liefern Hinweise. Erst zusammen mit Datenbankmetriken oder konkreten Logs wird daraus eine belastbare Diagnose.
Welche Fähigkeiten für DevOps-, Platform- und Cloud-Rollen zählen
OpenTelemetry allein macht noch keine vollständige DevOps- oder Platform-Rolle aus. Es ist aber ein sehr praxisnaher Baustein, weil du damit Anwendungen, Infrastruktur und Betriebsprozesse verbindest.
In DevOps-Rollen zählt, ob du Fehler reproduzierbar eingrenzen, sinnvolle Alarmierungen definieren und Entwicklungsteams bei der Instrumentierung unterstützen kannst. Für Platform Engineering ist wichtig, Telemetrie als wiederverwendbaren Standard bereitzustellen: mit Vorlagen, zentralen Collector-Konfigurationen, Zugriffsregeln und dokumentierten Konventionen. Einen breiteren Überblick über diese Aufgaben bekommst du in unserem Ratgeber Platform Engineering lernen für den Quereinstieg: Kubernetes, CI/CD und KI-Workloads verstehen.
Für Cloud-Rollen solltest du außerdem verstehen, wie Container, Identitäten, Netzwerke und Managed Services zusammenspielen. Beobachtbarkeit und Sicherheit gehören zusammen. Auffällige Zugriffsversuche, ungewöhnliche Fehlerraten oder unerwartete externe Aufrufe können relevante Hinweise sein. Wenn dich die Absicherung von Cloud-Workloads besonders interessiert, lies auch Cloud Security Engineer werden als Quereinsteiger: So sicherst du Cloud- und KI-Workloads ab.
Bei KI-Systemen kommen weitere Fragen hinzu: Wie lange dauern Modellanfragen? Wie häufig schlagen Tool-Aufrufe fehl? Welche Version eines Prompts oder Modells war aktiv? Wo entstehen Kosten oder ungewöhnlich lange Wartezeiten? Hier muss Telemetrie so gestaltet werden, dass sie technische Qualität sichtbar macht, ohne vertrauliche Inhalte unkontrolliert zu erfassen. Für den Betrieb und die Überwachung solcher Anwendungen ist auch LLMOps lernen für den Quereinstieg: KI-Anwendungen testen, überwachen und verbessern eine passende Ergänzung.
Häufige Fehler beim Einstieg
Ein typischer Fehler ist, nur Infrastrukturmetriken zu beobachten. CPU und Arbeitsspeicher sind wichtig, sagen aber wenig darüber aus, ob ein Nutzer eine Bestellung abschließen oder ein KI-Workflow zuverlässig arbeiten kann. Ergänze technische Werte daher durch anwendungsnahe Metriken.
Ebenso problematisch sind Traces ohne aussagekräftige Namen und Attribute. Wenn jeder Span nur „HTTP request“ heißt, erkennst du keine fachlichen Schritte. Benenne Operationen nachvollziehbar und nutze Attribute sparsam, aber konsistent.
Achte außerdem auf die Datenmenge. Jede einzelne Anfrage vollständig zu speichern, kann teuer und unübersichtlich werden. In produktiven Systemen werden Traces deshalb häufig gezielt ausgewählt, etwa bei Fehlern oder auffällig langen Laufzeiten. Dieses Sampling ist kein Detail, sondern Teil einer verantwortungsvollen Betriebsstrategie.
Dein nächster Schritt
Baue ein kleines Projekt, in dem du einen Fehler vom Symptom bis zur Ursache verfolgst. Dokumentiere dabei nicht nur die technische Lösung, sondern auch deine Untersuchung: Welche Metrik fiel auf? Welcher Trace zeigte den Engpass? Welcher Logeintrag bestätigte die Ursache? Genau diese Geschichte eignet sich später als Portfolio-Beispiel und zeigt, dass du Betriebssituationen strukturiert analysieren kannst.
Passende Seminare und Termine für deinen individuellen Weg in Cloud-, DevOps- und KI-Themen findest du bei uns auf cmt.de.
Nächster Schritt
Passenden Kurs zu Tech-Felder finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen
Mehr aus Tech-Felder
-
 KI SBOM und Software Supply Chain Security lernen für den Quereinstieg: Abhängigkeiten sicher verwalten 8 Min. Lesezeit
-
 KI KI Governance lernen für den Quereinstieg: So sorgst du für sichere und regelkonforme KI 8 Min. Lesezeit
-
 KI n8n lernen für den Quereinstieg: KI-Workflows und Automatisierungen sicher bauen 8 Min. Lesezeit