Tech-Felder
Data Engineering lernen für den Quereinstieg: So bereitest du Daten für KI und Analysen auf
Data Engineering lernen für den Quereinstieg: Welche Grundlagen, Tools und Projekte du für Datenpipelines, KI und Analytics brauchst.
 KI-generiert
Montagmorgen, das Vertriebsteam braucht aktuelle Kennzahlen für ein Meeting, doch die Daten liegen verteilt in einer CRM-Exportdatei, einer Datenbank und mehreren Tabellen. Gleichzeitig soll ein KI-Projekt starten, aber niemand kann zuverlässig sagen, welche Daten vollständig, aktuell und sauber genug sind. Genau an dieser Stelle beginnt Data Engineering: Du sorgst dafür, dass Daten nutzbar, nachvollziehbar und sicher für Analysen, Berichte und KI-Anwendungen bereitstehen.
Für Quereinsteiger ist das Feld interessant, weil Data Engineering mehrere praktische Bereiche verbindet. Du arbeitest mit Datenbanken, Programmierung, Cloud-Diensten und den Anforderungen von Fachbereichen. Anders als in rein analytischen Rollen liegt dein Schwerpunkt weniger darauf, Ergebnisse zu interpretieren. Du entwickelst die technische Grundlage, auf der Data Analysts, Data Scientists und KI-Teams arbeiten können.
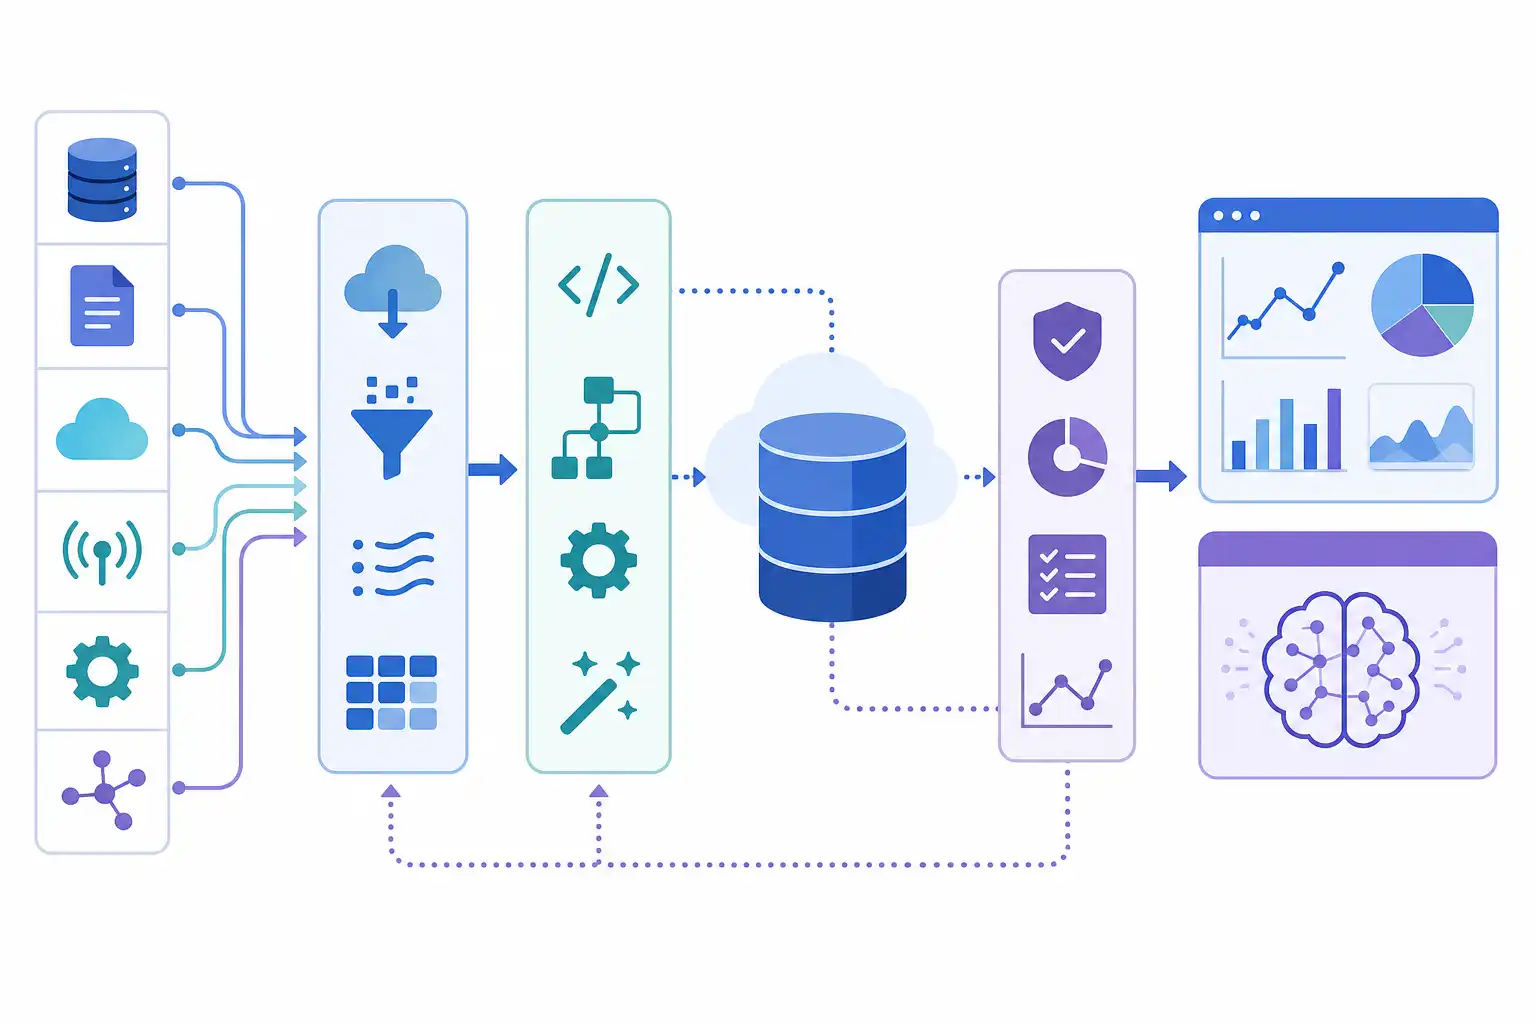
Infografik zu Data Engineering lernen für den Quereinstieg: So bereitest du Daten für KI und Analysen auf (KI-generiert).
Was Data Engineers in der Praxis tun
Data Engineers bauen und betreiben Datenpipelines. Eine Pipeline beschreibt den Weg von Daten aus einer Quelle bis zu einem Zielsystem, in dem sie ausgewertet oder weiterverarbeitet werden können. Typische Quellen sind Anwendungen, Datenbanken, Logdateien, APIs, Sensoren oder Dateien aus Fachabteilungen.
Eine gute Pipeline übernimmt nicht einfach Daten von A nach B. Sie prüft Datenqualität, dokumentiert ihre Verarbeitung und lässt sich zuverlässig wiederholen. Wenn eine Quelle ausfällt oder ein Feld plötzlich anders heißt, muss das Team erkennen können, was passiert ist.
Zu den typischen Aufgaben gehören:
- Daten aus Datenbanken, Dateien und APIs abrufen
- Daten bereinigen, vereinheitlichen und validieren
- Tabellen für Analysen und Reports modellieren
- Daten in Cloud-Speichern, Data Warehouses oder Datenbanken ablegen
- wiederkehrende Abläufe automatisieren und überwachen
- Zugriffsrechte, Datenschutzanforderungen und Dokumentation berücksichtigen
- mit Analytics-, Produkt- und KI-Teams abstimmen
Gerade für KI-Projekte ist diese Arbeit entscheidend. Ein Sprachmodell, ein Prognosemodell oder eine Suche mit Unternehmenswissen benötigt Daten, die strukturiert, aktuell und überprüfbar sind. Wenn Dubletten, falsche Zeitstempel oder unklare Berechtigungen in den Bestand gelangen, werden auch die Ergebnisse der KI unzuverlässig.
Der Unterschied zwischen Data Engineering, Data Science und Analytics
Die Rollen überschneiden sich, unterscheiden sich aber im Schwerpunkt. In kleineren Unternehmen kann eine Person mehrere Aufgaben übernehmen. Für deinen Einstieg hilft es trotzdem, die Abgrenzung zu kennen.
| Bereich | Kernfrage | Typische Ergebnisse |
|---|---|---|
| Data Engineering | Wie kommen verlässliche Daten in die richtigen Systeme? | Datenpipelines, Datenmodelle, Qualitätsprüfungen |
| Data Analytics | Was sagen die Daten über das Geschäft aus? | Dashboards, Kennzahlen, Auswertungen |
| Data Science | Welche Muster und Vorhersagen lassen sich aus Daten ableiten? | Modelle, Experimente, Prognosen |
| KI Engineering | Wie wird ein KI-System technisch sinnvoll eingesetzt? | Anwendungen, Schnittstellen, Retrieval-Systeme |
Data Engineering ist deshalb ein guter Einstieg für Menschen, die gerne strukturiert arbeiten und technische Probleme lösen. Du musst nicht sofort komplexe statistische Modelle entwickeln. Du solltest aber bereit sein, genau hinzuschauen: Woher kommt eine Zahl? Was bedeutet ein fehlender Wert? Welche Änderung an der Quelle beeinflusst einen Bericht?
Die Grundlagen, die du zuerst aufbauen solltest
Viele Tool-Listen wirken einschüchternd. Für den Quereinstieg ist es sinnvoller, die Lernreihenfolge an echten Arbeitsabläufen auszurichten. Beginne mit wenigen Grundlagen, die du wiederholt in Projekten einsetzt.
SQL: Dein wichtigstes Werkzeug für Daten
SQL ist die Sprache, mit der du Daten aus relationalen Datenbanken abfragst und verarbeitest. Du solltest nicht nur einfache Abfragen schreiben, sondern verstehen, wie Tabellen miteinander verbunden werden.
Für den Einstieg brauchst du unter anderem:
- SELECT, WHERE, ORDER BY und GROUP BY
- JOINs zwischen mehreren Tabellen
- Aggregationen wie COUNT, SUM und AVG
- CASE-Ausdrücke für Regeln und Kategorien
- CTEs für besser lesbare Abfragen
- Window Functions für Zeitreihen, Rangfolgen und Vergleiche
- Grundlagen von Indizes und Abfrageperformance
Übe SQL nicht nur mit einzelnen Tabellen. Nimm ein kleines Datenset mit Kunden, Bestellungen und Produkten. Berechne beispielsweise Umsatz pro Monat, Wiederkäufe oder Lieferzeiten. So lernst du gleichzeitig, wie Geschäftslogik in Daten abgebildet wird.
Python: Automatisieren und Daten verarbeiten
Python brauchst du im Data Engineering vor allem für wiederholbare Verarbeitungsschritte. Ein Skript kann Daten aus einer API laden, Spalten prüfen, fehlerhafte Werte protokollieren und das Ergebnis in einer Datenbank speichern.
Konzentriere dich zunächst auf:
- Variablen, Schleifen, Funktionen und Fehlerbehandlung
- Arbeiten mit Dateien wie CSV und JSON
- HTTP-Anfragen an APIs
- Datenverarbeitung mit pandas
- Datenbankverbindungen
- Logging für nachvollziehbare Abläufe
- virtuelle Umgebungen und Abhängigkeiten
Wichtig ist nicht, möglichst viele Bibliotheken auswendig zu lernen. Dein Code sollte lesbar sein, Fehler verständlich melden und erneut ausführbar sein. Wenn dein Skript beim zweiten Durchlauf doppelte Datensätze erzeugt, ist das ein Problem, das du bewusst lösen solltest.
Datenbanken und Datenmodellierung verstehen
Data Engineering ist mehr als Programmieren. Du brauchst ein Gefühl dafür, wie Daten gespeichert werden und welche Struktur spätere Analysen erleichtert.
Lerne die Unterschiede zwischen:
- relationalen Datenbanken wie PostgreSQL
- dokumentenorientierten Datenbanken
- Data Warehouses für analytische Abfragen
- Data Lakes für große, unterschiedlich strukturierte Datenbestände
- Objekt-Speichern in Cloud-Umgebungen
Für analytische Datenmodelle ist das Sternschema ein guter Startpunkt. Dabei verknüpfst du eine Faktentabelle, etwa Bestellungen, mit Dimensionstabellen wie Kunde, Produkt und Datum. Diese Struktur macht Kennzahlen verständlicher und Abfragen oft einfacher.
Cloud, Versionsverwaltung und Container
In vielen Teams laufen Datenpipelines nicht auf dem eigenen Laptop, sondern in einer Cloud-Umgebung. Du musst nicht sofort alle Dienste eines Anbieters beherrschen. Verstehe aber die wiederkehrenden Konzepte: Speicher, Rechenleistung, Identitäten, Netzwerkzugriffe, Monitoring und Kostenkontrolle.
Git gehört ebenfalls früh dazu. Speichere deine SQL-Abfragen, Python-Skripte und Projektbeschreibung in einem Repository. Schreibe klare Commit-Nachrichten und halte Konfigurationsdaten von Zugangsdaten getrennt.
Docker ist ein sinnvoller nächster Schritt. Container helfen dir, eine Anwendung mit ihren Abhängigkeiten reproduzierbar auszuführen. Das ist besonders nützlich, wenn dein Projekt aus Datenbank, Skript und Orchestrierung besteht.
Tools: Weniger sammeln, mehr beherrschen
Ein realistisches Lernziel ist kein vollständiger Werkzeugkatalog. Wähle ein Set, mit dem du einen Datenfluss von der Quelle bis zur Auswertung umsetzen kannst.
| Aufgabe | Sinnvolle Einstiegsoptionen |
|---|---|
| Datenbank | PostgreSQL |
| Abfragen und Transformationen | SQL, dbt |
| Programmierung | Python, pandas |
| Orchestrierung | Apache Airflow oder Prefect |
| Container | Docker |
| Versionsverwaltung | Git und GitHub oder GitLab |
| Cloud-Grundlagen | ein großer Cloud-Anbieter mit Objekt-Speicher und Datenbankdiensten |
| große Datenmengen | Apache Spark, wenn dein Projekt ihn wirklich braucht |
dbt ist für viele Einsteiger besonders hilfreich, weil du Transformationen mit SQL definierst, Tests ergänzt und Dokumentation erzeugst. Airflow oder Prefect zeigen dir anschließend, wie einzelne Schritte geplant und überwacht werden. Starte nicht gleichzeitig mit mehreren Cloud-Anbietern und mehreren Orchestrierungswerkzeugen. Tiefe entsteht durch Wiederholung in einem Projekt.
Drei Portfolio-Projekte, die deine Fähigkeiten sichtbar machen
Ein Portfolio überzeugt nicht durch eine lange Liste von Kursen. Es zeigt, dass du Anforderungen in eine funktionierende, dokumentierte Lösung übersetzen kannst. Verwende öffentlich verfügbare oder selbst erzeugte Daten und erkläre transparent, woher sie stammen.
1. Verkaufsdaten als tägliche Pipeline
Erstelle eine Pipeline, die Bestell- und Produktdaten aus CSV-Dateien einliest. Bereinige Datumswerte, entferne Dubletten und prüfe, ob Produkt-IDs gültig sind. Lade die Daten in PostgreSQL und erstelle ein analytisches Modell für Umsatz, Bestellmenge und Retouren.
Dokumentiere dabei:
- welche Datenquellen du annimmst
- welche Qualitätsregeln gelten
- wie du fehlerhafte Datensätze behandelst
- wie die Tabellen zusammenhängen
- wie der Ablauf lokal gestartet wird
2. API-Daten mit Monitoring verarbeiten
Nutze eine öffentliche API, etwa für Wetter-, Verkehrs- oder Veranstaltungsdaten. Dein Python-Skript ruft die Daten regelmäßig ab und speichert Rohdaten getrennt von aufbereiteten Daten. Ergänze Logging und eine einfache Benachrichtigung bei Fehlern.
Dieses Projekt zeigt, dass du mit instabilen Datenquellen umgehen kannst. APIs liefern nicht immer alle Felder, können Anfragen begrenzen oder ihre Antworten verändern. Beschreibe, wie deine Pipeline darauf reagiert.
3. Datenbasis für eine KI-Anwendung vorbereiten
Baue eine kleine Pipeline für eine Wissenssammlung aus öffentlich verfügbaren Textdokumenten. Extrahiere Inhalte, entferne doppelte Dokumente, versieh sie mit Metadaten wie Quelle und Aktualisierungsdatum und speichere sie in einer durchsuchbaren Struktur.
Der entscheidende Punkt ist nicht ein spektakulärer Chatbot. Zeige, wie du Datenqualität sicherst: Welche Dokumente werden ausgeschlossen? Wie erkennst du veraltete Inhalte? Welche Metadaten braucht eine Anwendung, um Antworten nachvollziehbar zu machen?
So bereitest du dich auf Bewerbungen vor
Stellenanzeigen verlangen häufig viele Technologien. Lies sie als Orientierung, nicht als Checkliste, die du vollständig abhaken musst. Suche nach wiederkehrenden Aufgaben: SQL, Datenpipelines, Cloud, Datenqualität und Zusammenarbeit mit Fachbereichen sind oft wichtiger als ein einzelnes Tool.
Dein Lebenslauf sollte dein bisheriges Wissen sinnvoll mit Data Engineering verbinden. Erfahrung aus Buchhaltung, Logistik, Vertrieb, Produktion oder Kundenservice kann wertvoll sein, wenn du verstehst, wie dort Daten entstehen und genutzt werden. Beschreibe nicht nur Tools, sondern Ergebnisse: „Pipeline für tägliche Datenaktualisierung entwickelt“ ist aussagekräftiger als „Python gelernt“.
Vor einem Gespräch solltest du jedes Portfolio-Projekt erklären können:
- Welches Problem löst die Pipeline?
- Wie sehen Quelle, Verarbeitung und Ziel aus?
- Welche Datenqualitätsprüfungen gibt es?
- Was passiert bei einem Fehler?
- Was würdest du bei größerer Datenmenge anders bauen?
- Welche Annahmen und Grenzen hat deine Lösung?
Wir erleben in Trainings immer wieder, dass ein sauber dokumentiertes Projekt mit überschaubarem Umfang überzeugender wirkt als eine Sammlung unfertiger Experimente. Passende Seminare und Termine findest du bei uns auf cmt.de.
Ein realistischer Lernplan für deinen Einstieg
Plane feste Lernzeiten und arbeite früh projektorientiert. Erst Theorie bis zur vermeintlichen Perfektion zu sammeln, führt oft dazu, dass der praktische Zusammenhang fehlt.
Ein sinnvoller Ablauf kann so aussehen:
- Zuerst SQL und Datenmodellierung mit einer relationalen Datenbank üben
- Danach Python einsetzen, um Dateien und APIs zu verarbeiten
- Anschließend ein vollständiges Projekt mit Datenqualität und Dokumentation bauen
- Git und Docker in dieses Projekt integrieren
- Dann Cloud-Grundlagen und Orchestrierung ergänzen
- Zum Schluss dein Projekt überarbeiten, testen und verständlich präsentieren
Data Engineering ist kein Beruf, in dem du nach einem Kurs „fertig“ bist. Datenquellen, Cloud-Dienste und Anforderungen verändern sich. Mit soliden Grundlagen und mehreren nachvollziehbaren Projekten schaffst du aber eine belastbare Basis für den Quereinstieg. Entscheidend ist, dass du nicht nur Daten bewegen kannst, sondern ihre Herkunft, Qualität und Nutzung im Blick behältst.
Nächster Schritt
Passenden Kurs zu Tech-Felder finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen